在企業評估與部署 AI 自動化工具的過程中,許多團隊都會面臨同一個痛點:「AI 技能包寫得越詳細,對話花費的 Token 就越高,算力成本與反應延遲也隨之暴增。」
當我們把兩套或多套專業技能、規範與範本,全數包裝進單一提示詞(Prompt)或靜態檔案中,每一次的互動都是對 Context Window(上下文視窗)的巨大浪費。事實證明,將大型技能包拆解並重構成「工作流(Workflow / Agentic Multi-step Pattern)」,能夠直接為企業省下高達 80% 至 90% 的 Token 消耗。
一、龐大技能包的隱形威脅:Token 浪費與效能下降
許多人在設計技能模組時,習慣採用「全包式(Monolithic)」做法,把背景知識、檢核標準、例外處理與輸出格式通通塞在一起。這會帶來三大瓶頸:
- 靜態成本極高: 模型每次回應時,即便使用者只發問了一個小問題,系統仍必須將整份龐大的技能說明重讀一遍。
- 上下文干擾(Context Noise): 資訊量過多會分散模型的注意力,導致模型出現「細節遺漏」或「未遵守特定規則」的情況。
- 無效資訊累積: 長時間對話下來,過去步驟中的冗長中間過程持續留在上下文記憶中,造成算力與 Token 資源的無謂消耗。
二、工作流架構如何實現 80~90% 的 Token 節省?
「工作流」的核心思想,是將複雜的任務鏈拆解為獨立、單一職責的節點(Nodes),並透過狀態管理進行運作:
1. 按需載入(Lazy Loading)與動態分流
在工作流架構下,首頁只運作一個極小的「路由主控(Router)」。當使用者輸入需求時,路由主控僅會調用當下節點需要的最小技能模組,而非一次把所有資料載入記憶體。
2. 狀態傳遞(Stateful Handoff)取代全文本保留
傳統對話會把歷史訊息完整帶入下一次運算;而工作流在步驟轉換時,只傳遞結構化的關鍵狀態(例如 JSON 格式的數據或精簡摘要)。過濾掉了 90% 以上的不必要對話細節,大幅縮減 Context Window 的體積。
3. 模組化與組件複用
將大技能包拆分成「資料擷取」、「邏輯分析」、「格式生成」等獨立組件。只有當觸發特定條件時才啟動專用組件,讓每單位算力都花在刀口上。
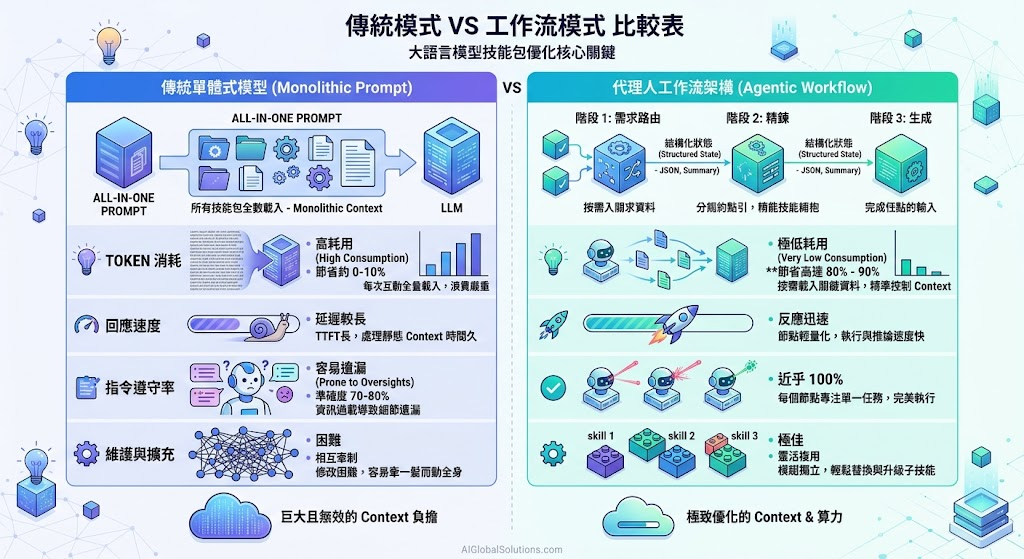
三、傳統模式 vs. 工作流模式 比較表
| 評估項目 | 傳統單體技能包 (Monolithic Prompt) | 模組化工作流 (Workflow Architecture) |
|---|---|---|
| Token 消耗 | 每次互動載入全量 Context,耗用量極高 | 按步驟動態載入,節省 80%~90% Token |
| 回應速度 | 輸入 Token 龐大,推論首字延遲(TTFT)較長 | 節點輕量化,回應與執行速度顯著提升 |
| 遵守指令率 | 容易因資訊過載而漏掉關鍵規則 | 每個節點專注單一任務,準確度近乎 100% |
| 維護與擴充 | 修改單一規則可能影響整體對話表現 | 模組獨立,可針對單一步驟輕鬆微調與擴充 |
結語:從「Prompt Engineering」邁向「Agentic Workflow」
在 AI 應用邁入成熟期的今天,極致的成本控制與優異的系統穩定度,是企業能否大規模落地 AI 的兩大關鍵。
告別過去「把所有知識塞進巨大 Prompt」的作法,改採模組化工作流,不僅能帶來高達數倍的成本優勢,更能打造出反應更迅速、邏輯更嚴密的 AI 系統。