在企业评估与部署 AI 自动化工具的过程中,许多团队都会面临同一个痛点:「AI 技能包写得越详细,对话花费的 Token 就越高,算力成本与反应延迟也随之暴增。」
当我们把两套或多套专业技能、规范与范本,全数包装进单一提示词(Prompt)或静态档案中,每一次的互动都是对 Context Window(上下文视窗)的巨大浪费。事实证明,将大型技能包拆解并重构成「工作流(Workflow / Agentic Multi-step Pattern)」,能够直接为企业省下高达 80% 至 90% 的 Token 消耗。
一、庞大技能包的隐形威胁:Token 浪费与效能下降
许多人在设计技能模组时,习惯采用「全包式(Monolithic)」做法,把背景知识、检核标准、例外处理与输出格式通通塞在一起。这会带来三大瓶颈:
- 静态成本极高: 模型每次回应时,即便使用者只发问了一个小问题,系统仍必须将整份庞大的技能说明重读一遍。
- 上下文干扰(Context Noise): 资讯量过多会分散模型的注意力,导致模型出现「细节遗漏」或「未遵守特定规则」的情况。
- 无效资讯累积: 长时间对话下来,过去步骤中的冗长中间过程持续留在上下文记忆中,造成算力与 Token 资源的无谓消耗。
二、工作流架构如何实现 80~90% 的 Token 节省?
「工作流」的核心思想,是将复杂的任务链拆解为独立、单一职责的节点(Nodes),并透过状态管理进行运作:
1. 按需载入(Lazy Loading)与动态分流
在工作流架构下,首页只运作一个极小的「路由主控(Router)」。当使用者输入需求时,路由主控仅会调用当下节点需要的最小技能模组,而非一次把所有资料载入记忆体。
2. 状态传递(Stateful Handoff)取代全文本保留
传统对话会把历史讯息完整带入下一次运算;而工作流在步骤转换时,只传递结构化的关键状态(例如 JSON 格式的数据或精简摘要)。过滤掉了 90% 以上的不必要对话细节,大幅缩减 Context Window 的体积。
3. 模组化与组件复用
将大技能包拆分成「资料撷取」、「逻辑分析」、「格式生成」等独立组件。只有当触发特定条件时才启动专用组件,让每单位算力都花在刀口上。
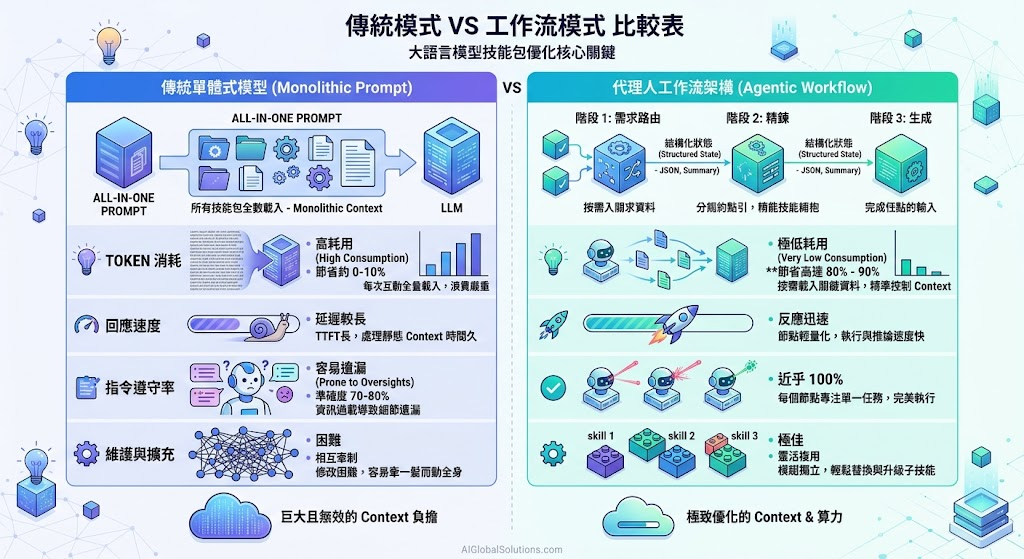
三、传统模式 vs. 工作流模式 比较表
| 评估项目 | 传统单体技能包 (Monolithic Prompt) | 模组化工作流 (Workflow Architecture) |
|---|---|---|
| Token 消耗 | 每次互动载入全量 Context,耗用量极高 | 按步骤动态载入,节省 80%~90% Token |
| 回应速度 | 输入 Token 庞大,推论首字延迟(TTFT)较长 | 节点轻量化,回应与执行速度显着提升 |
| 遵守指令率 | 容易因资讯过载而漏掉关键规则 | 每个节点专注单一任务,准确度近乎 100% |
| 维护与扩充 | 修改单一规则可能影响整体对话表现 | 模组独立,可针对单一步骤轻松微调与扩充 |
结语:从「Prompt Engineering」迈向「Agentic Workflow」
在 AI 应用迈入成熟期的今天,极致的成本控制与优异的系统稳定度,是企业能否大规模落地 AI 的两大关键。
告别过去「把所有知识塞进巨大 Prompt」的作法,改采模组化工作流,不仅能带来高达数倍的成本优势,更能打造出反应更迅速、逻辑更严密的 AI 系统。